Blog
Phát triển bản thân · Công nghệ · Review dự án

LLM Routing: Chọn Model Phù Hợp Tự Động Tiết Kiệm 70% Chi Phí
LLM routing tự động chọn model phù hợp cho từng tác vụ, giảm 70% chi phí mà vẫn giữ chất lượng. Tìm hiểu các chiến lược routing và cách triển khai thực tế.

Compound AI Systems: Kết Hợp Nhiều Model AI Thông Minh Hơn Một Model Khổng Lồ
Xu hướng mới trong AI: Thay vì model khổng lồ, kết hợp nhiều component AI nhỏ hơn để đạt kết quả tốt hơn với chi phí thấp hơn.

AI SDK & Frameworks: Vercel AI SDK, LlamaIndex, LangChain So Sánh 2026
So sánh 3 framework AI phổ biến nhất 2026: Vercel AI SDK cho web dev, LlamaIndex cho RAG, LangChain cho agents. Code thực tế + use case từng cái.
Prompt Caching: Giảm 90% Chi Phí API Khi Dùng AI Nhiều Lần
Prompt Caching giúp giảm 90% cost API AI khi gọi lặp đi lặp lại với context dài. Anthropic, OpenAI, Google đều hỗ trợ. Hướng dẫn thực chiến + case study.
vLLM & Continuous Batching: Tăng Throughput LLM Gấp 20 Lần
vLLM tăng throughput LLM gấp 14-24 lần nhờ continuous batching và PagedAttention, giảm chi phí serving đến 90% so với HuggingFace Transformers.
System Prompts & System Instructions: Thiết Kế Bộ Não Cho AI Chatbot
System prompts định hình cách AI suy nghĩ và phản hồi. Hướng dẫn chi tiết viết system instructions hiệu quả cho chatbot, assistant và AI agent.
Attention Mechanisms: Bí Mật Giúp Transformer Và LLM Thông Minh
Cơ chế Attention là trái tim của Transformer và LLM. Tìm hiểu self-attention, multi-head attention, scaled dot-product và cách chúng giúp AI hiểu ngữ cảnh.
AI Code Review: Tự Động Kiểm Tra Chất Lượng Code Với AI 2026
AI code review giúp phát hiện bug, lỗi bảo mật và code smell tự động. Tìm hiểu các công cụ GitHub Copilot, Amazon CodeWhisperer, DeepCode và cách áp dụng hiệu quả.
Prompt Caching: Tiết Kiệm 90% Chi Phí Token Khi Dùng LLM
Prompt Caching giúp bạn tiết kiệm tới 90% chi phí token khi dùng LLM bằng cách tái sử dụng phần prompt lặp lại. Hướng dẫn chi tiết cách dùng trên Claude, GPT-4.
Hybrid Search: Kết Hợp Full-text & Vector Search Cho RAG Chính Xác Hơn
Hybrid search kết hợp BM25 và vector search giúp RAG chính xác hơn 30-40%. Hướng dẫn chi tiết cách implement và khi nào nên dùng.
Neural Architecture Search: AI Tự Thiết Kế Kiến Trúc Cho Chính Nó 2026
NAS giúp AI tự động tìm kiếm và thiết kế kiến trúc neural network tối ưu, thay thế việc điều chỉnh thủ công mất hàng tuần công sức
Neural Architecture Search: Tự Động Tìm Kiến Trúc AI Tối Ưu 2026
Neural Architecture Search (NAS) tự động thiết kế mạng neural tối ưu, tiết kiệm hàng tuần công nghiên cứu. Khám phá cách hoạt động, ưu nhược điểm và khi nào nên dùng.
AutoML: Tự Động Xây Dựng Model AI Không Cần Chuyên Gia 2026
AutoML giúp xây dựng model AI tự động, từ chọn thuật toán đến tinh chỉnh siêu tham số. Giảm 90% thời gian phát triển, dân hóa AI cho mọi người.
XAI (Explainable AI): Giải Thích Cách AI Đưa Ra Quyết Định 2026
XAI giúp hiểu cách AI ra quyết định. Tìm hiểu LIME, SHAP, attention và tại sao tính minh bạch AI quan trọng trong tài chính, y tế năm 2026.
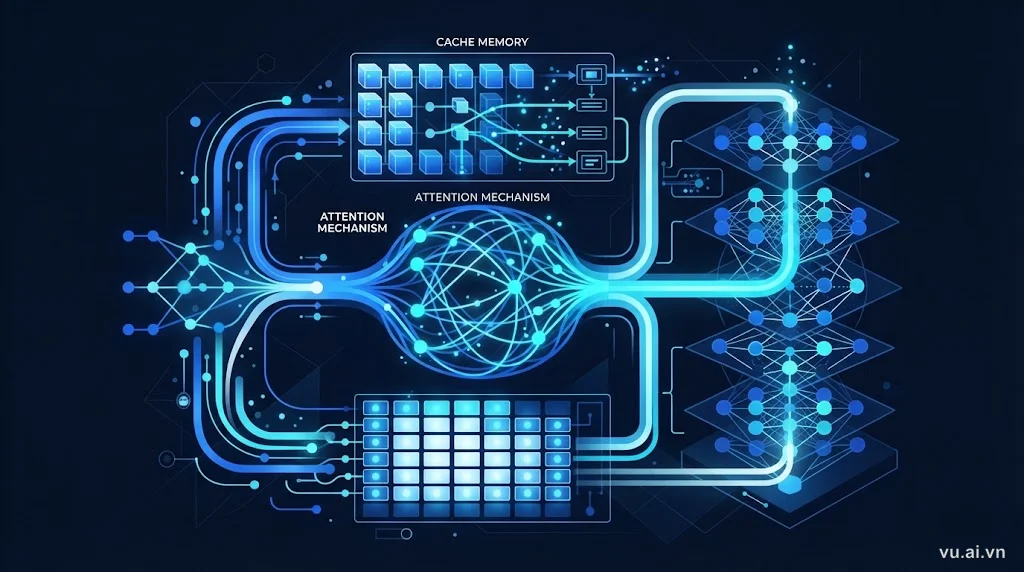
KV Cache & Attention Optimization: Bí Quyết LLM Xử Lý Nhanh Context Dài
Khám phá cách KV Cache và kỹ thuật tối ưu Attention giúp LLM xử lý context dài nhanh gấp 10 lần mà vẫn giữ chất lượng. Hướng dẫn chi tiết cho developer AI.
Speculative Decoding: Tăng Tốc LLM Gấp Đôi Không Cần Thay Model
Speculative Decoding giúp tăng tốc inference LLM gấp 2-3 lần mà không mất chất lượng, bằng cách dùng model nhỏ dự đoán trước và model lớn xác nhận sau.
AI Model Compression: Nén Model Giảm 90% Kích Thước Mà Vẫn Giữ Hiệu Suất
Hướng dẫn chi tiết 4 kỹ thuật nén model AI: Quantization, Pruning, Knowledge Distillation, Low-rank. Giảm kích thước 90%, tăng tốc inference 5-10 lần.
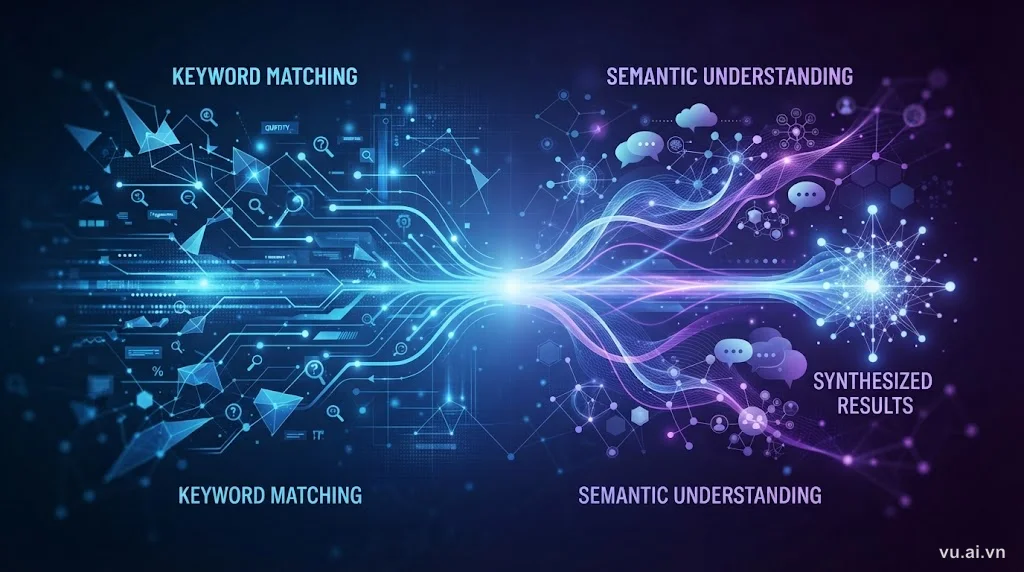
Hybrid Search: Kết Hợp Keyword & Semantic Search Cho Kết Quả Tốt Nhất
Hybrid search kết hợp tìm kiếm từ khóa truyền thống (BM25) và semantic search (vector) để cho kết quả chính xác và đầy đủ hơn. Hướng dẫn cách triển khai cho RAG system.
LoRA và PEFT: Fine-tune LLM Rẻ 10 Lần Không Cần GPU Khủng
Hướng dẫn chi tiết LoRA và Parameter-Efficient Fine-Tuning: tùy biến LLM với chi phí thấp, không cần GPU đắt tiền. So sánh Full Fine-tuning vs LoRA.
GraphRAG: Kết Hợp Graph Database & RAG Cho AI Thông Minh Hơn
Khám phá GraphRAG - kỹ thuật kết hợp graph database và RAG giúp AI hiểu mối quan hệ phức tạp, trả lời câu hỏi đa bước chính xác hơn. Hướng dẫn chi tiết cho developer.
AI Recommendation Systems: Thuật Toán Gợi Ý Từ Netflix Đến TikTok 2026
Hệ thống gợi ý AI đang định hình cách chúng ta tiêu thụ nội dung. Tìm hiểu collaborative filtering, content-based, hybrid models và cách các nền tảng lớn áp dụng.
Test-time Compute: Khi AI Càng Suy Nghĩ Lâu Càng Thông Minh
Test-time compute là kỹ thuật cho phép AI sử dụng thêm thời gian suy nghĩ để giải quyết bài toán phức tạp hiệu quả hơn. Tìm hiểu cách hoạt động & ứng dụng thực tế.
AI Assistants & Personal Agents: Trợ Lý AI Cá Nhân Năm 2026
Tìm hiểu AI assistants và personal agents hoạt động như thế nào, so sánh ChatGPT, Claude, AutoGPT và cách chọn trợ lý AI phù hợp cho công việc hàng ngày.
Tokenization Trong LLM: Cách AI Hiểu Text Từng Mảnh Nhỏ
Tokenization là bước đầu tiên để AI hiểu ngôn ngữ tự nhiên. Tìm hiểu cách LLM phân tích text thành token, tại sao nó quan trọng, và ảnh hưởng đến chi phí API.
Tối Ưu Chi Phí AI/LLM: 8 Chiến Lược Tiết Kiệm Đến 90% (2026)
Hướng dẫn chi tiết 8 phương pháp đã được chứng minh giúp giảm chi phí vận hành AI/LLM từ 50-90% mà vẫn giữ chất lượng output.
AI Testing & Evaluation: Đánh Giá Chất Lượng Output LLM 2026
Cách đo lường, kiểm thử và đảm bảo chất lượng output của LLM trong production. Framework thực tế, metrics quan trọng và công cụ cho 2026.
Structured Output & JSON Mode: Lập Trình AI Đáng Tin Cậy 2026
Structured output và JSON mode giúp AI trả lời đúng format 100%, không hallucination JSON. Hướng dẫn chi tiết cho lập trình viên.
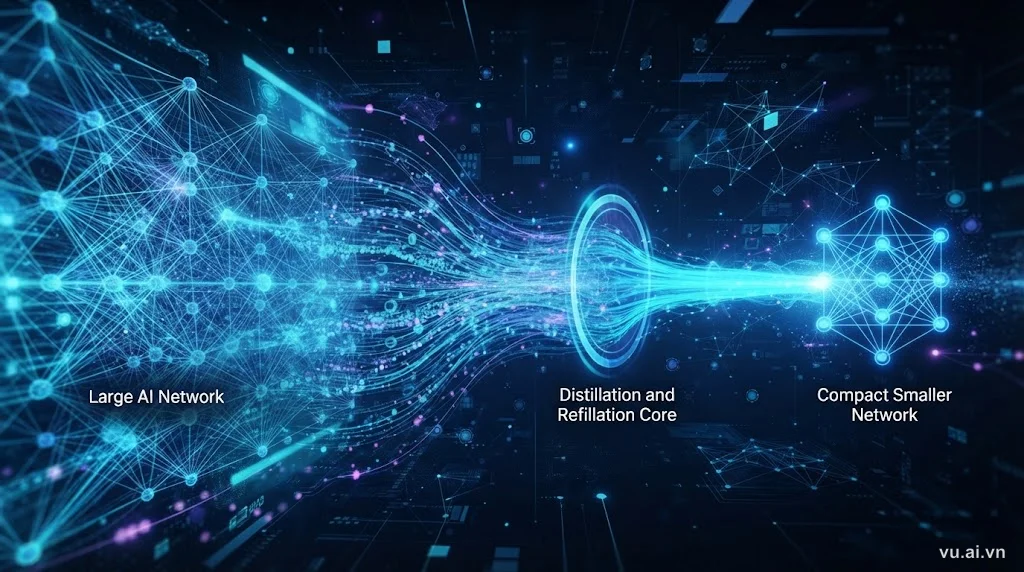
Model Distillation: Chưng Cất AI Từ Lớn Thành Nhỏ Mà Vẫn Thông Minh
Model distillation giúp tạo AI model nhỏ gọn từ model khổng lồ, chạy nhanh hơn 10 lần mà vẫn giữ 95%+ hiệu suất. Tìm hiểu cách hoạt động và khi nào nên dùng.
AI Model Serving & Deployment: Đưa AI Vào Production 2026
Hướng dẫn deploy AI model lên production: từ model serving infrastructure, API design, đến scaling và monitoring thực tế năm 2026.
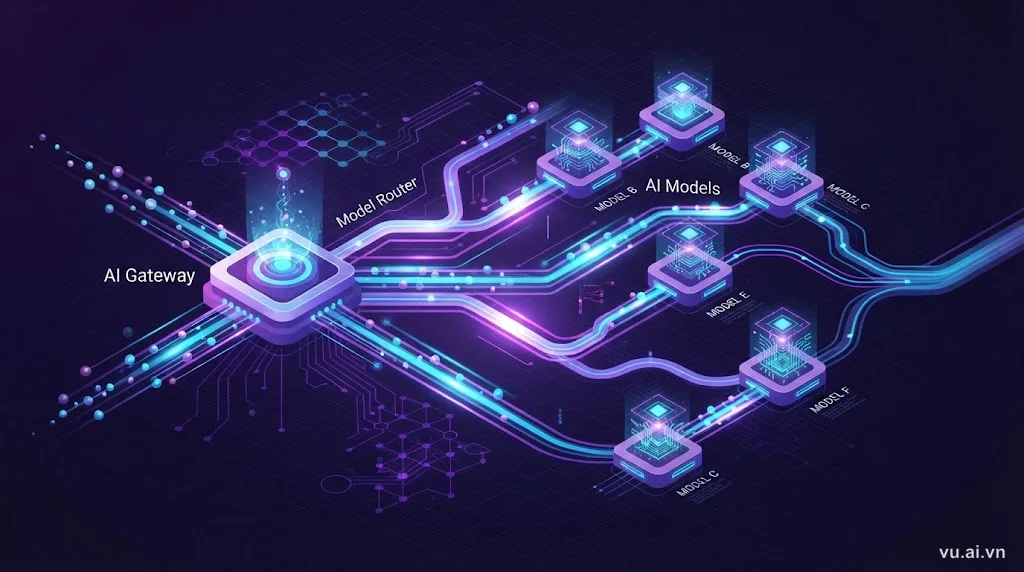
AI Gateway & Model Router: Quản Lý Nhiều LLM Thông Minh 2026
AI Gateway giúp bạn quản lý nhiều model AI, routing thông minh, load balancing và tiết kiệm chi phí. Tìm hiểu LiteLLM, Portkey và cách xây dựng gateway riêng.
Streaming AI Responses: Trải Nghiệm Realtime Với LLM 2026
Streaming AI giúp người dùng thấy câu trả lời từng từ một, giảm thời gian chờ và tăng tương tác. Tìm hiểu cách hoạt động và ứng dụng thực tế.
AI Content Moderation: Kiểm Duyệt Nội Dung Tự Động 2026
AI Content Moderation giúp kiểm duyệt spam, toxic, vi phạm pháp luật tự động 24/7. OpenAI, Perspective API & cách triển khai thực tế cho web/app.
Streaming Trong LLM: Tăng Tốc Trải Nghiệm AI Real-time 2026
Token-by-token streaming biến trải nghiệm AI từ chờ đợi nhàm chán thành tương tác sống động. Hiểu rõ cơ chế, lợi ích và cách triển khai streaming cho ứng dụng LLM của bạn.
Prompt Injection & AI Security: Bảo Vệ Ứng Dụng AI Khỏi Tấn Công 2026
Prompt injection đang trở thành lỗ hổng bảo mật lớn nhất của ứng dụng AI. Hướng dẫn nhận biết, phòng chống và bảo vệ chatbot, RAG, agent khỏi tấn công thực tế.
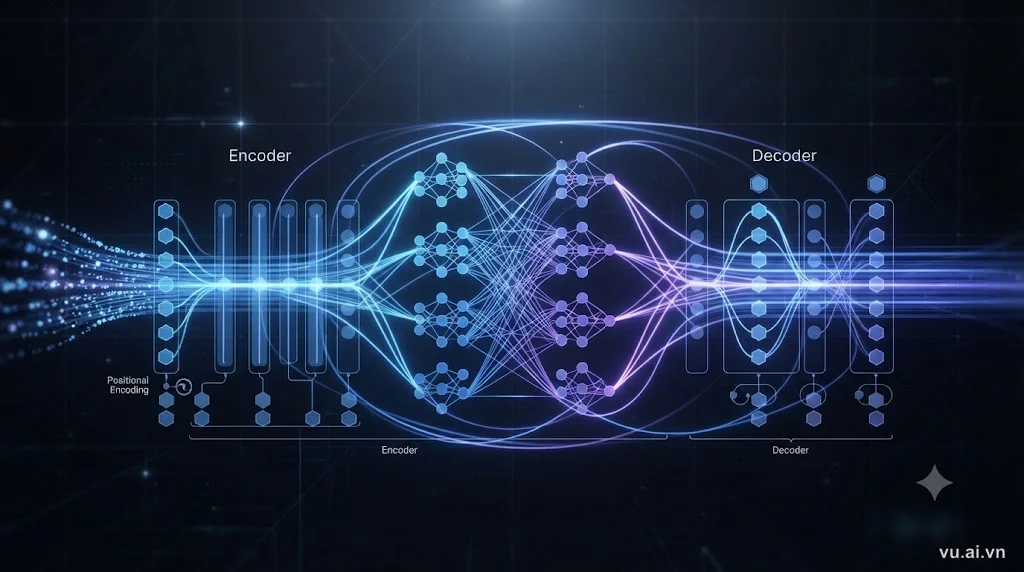
Transformer Architecture & Attention Mechanism: Nền Tảng Kỹ Thuật Của Mọi LLM 2026
Hiểu rõ kiến trúc Transformer và cơ chế Attention — xương sống của GPT, Claude, Gemini. Từ self-attention đến multi-head, giải mã cách AI hiểu ngữ cảnh.
AI Observability: Giám Sát & Debug AI Model Trong Production 2026
Hướng dẫn chi tiết cách giám sát, debug và tối ưu AI model trong production — từ logging, tracing đến phát hiện drift và hallucination real-time
AI Alignment: Căn Chỉnh AI Theo Giá Trị Con Người Năm 2026
AI Alignment đảm bảo AI hoạt động đúng mục tiêu con người. Tìm hiểu RLHF, Constitutional AI và thách thức căn chỉnh hệ thống AI an toàn.
Constitutional AI: Huấn Luyện AI Tuân Thủ Nguyên Tắc Đạo Đức Tự Động
Constitutional AI (CAI) giúp AI tự học cách trả lời an toàn, đạo đức mà không cần hàng nghìn người dán nhãn. Cách Anthropic huấn luyện Claude tuân thủ hiến pháp AI.
AI Guardrails: Kiểm Soát và Định Hướng Output AI An Toàn 2026
Hệ thống guardrails giúp kiểm soát output AI, ngăn hallucination, toxic content và bias. Framework thực tế + công cụ open-source + khi nào nên dùng.
RAG Nâng Cao: Xây Dựng Hệ Thống Q&A Thông Minh Từ Dữ Liệu Riêng
Hướng dẫn triển khai RAG nâng cao với chunking thông minh, hybrid search, reranking và multi-hop reasoning để xây hệ thống Q&A chính xác từ dữ liệu riêng.
AI Model Benchmarks: Cách Đo Và So Sánh Chất Lượng LLM 2026
Hướng dẫn đọc hiểu các chỉ số benchmark MMLU, HumanEval, MT-Bench, Arena ELO để chọn model AI phù hợp. Tại sao benchmark không phải tất cả?
AI Memory Systems: Mem0, Zep và Cách Chatbot Nhớ Ngữ Cảnh Dài Hạn 2026
Hướng dẫn chi tiết AI Memory Systems: Mem0, Zep, vector memory giúp chatbot nhớ cuộc hội thoại dài hạn. Từ lý thuyết đến thực hành.
Local LLM: Chạy AI Mạnh Mẽ Trên Máy Tính Cá Nhân 2026
Hướng dẫn chi tiết chạy mô hình ngôn ngữ lớn trên máy tính cá nhân với Ollama, LM Studio. Riêng tư, nhanh, không tốn tiền API.
Transfer Learning: Tái Sử Dụng Model AI Tiết Kiệm 90% Chi Phí
Transfer learning cho phép tái sử dụng model AI đã huấn luyện để giải quyết bài toán mới với ít dữ liệu và chi phí thấp hơn 90%. Hướng dẫn chi tiết.
Zero-shot & Few-shot Learning: AI Học Với Ít Hoặc Không Cần Dữ Liệu
Tìm hiểu Zero-shot và Few-shot Learning — kỹ thuật giúp AI thực hiện tác vụ mới mà không cần huấn luyện lại. In-context learning, prompt engineering và ứng dụng thực tế 2026.
Synthetic Data: Tạo Dữ Liệu Giả Để Huấn Luyện AI Chất Lượng Cao
Tìm hiểu cách các công ty AI hàng đầu dùng dữ liệu tổng hợp để giải quyết vấn đề khan hiếm data, bảo vệ privacy và giảm đáng kể chi phí huấn luyện model.
Agentic AI Workflows: LangChain, LangGraph và Tương Lai Tự Động Hóa 2026
Khám phá cách xây dựng AI workflows phức tạp với LangChain và LangGraph. Hướng dẫn chi tiết về agentic AI, tool use và orchestration cho developer.
Multi-Agent Systems: AI Đa Nhiệm Tự Động Hóa Công Việc Phức Tạp
Hệ thống multi-agent cho phép nhiều AI agent cộng tác xử lý task phức tạp — từ nghiên cứu thị trường đến code review tự động. Cách hoạt động, framework và ứng dụng thực tế.
Semantic Caching Trong LLM: Tiết Kiệm 90% Chi Phí API AI
Semantic caching giúp giảm 70-90% chi phí API LLM bằng cách cache câu trả lời theo ngữ nghĩa, không cần khớp chính xác. Hướng dẫn chi tiết cách triển khai.
Small Language Models (SLM): Xu Hướng AI Nhỏ Gọn Nhưng Cực Mạnh 2026
SLM - mô hình ngôn ngữ nhỏ gọn dưới 10B tham số - đang thay đổi cách chúng ta triển khai AI. Tìm hiểu tại sao và khi nào nên dùng SLM thay vì LLM khổng lồ.
Mixture of Experts (MoE): Bí Mật LLM Khổng Lồ Nhưng Nhanh 2026
MoE giúp GPT-4, Mixtral, DeepSeek chạy nhanh gấp 6 lần dù có hàng trăm tỷ tham số. Hiểu cách hoạt động và khi nào nên dùng.
Hallucination AI: Tại Sao AI Đôi Khi Bịa Chuyện và Cách Phòng Tránh
AI hallucination là gì? Tìm hiểu nguyên nhân ChatGPT, Claude, Gemini đôi khi đưa ra thông tin sai lệch và 7 cách phòng tránh hiệu quả năm 2026.
Chain-of-Thought & Reasoning AI: O1, DeepSeek-R1 và Tương Lai Suy Luận
Khám phá cách AI học suy luận từng bước qua Chain-of-Thought, từ O1 của OpenAI đến DeepSeek-R1, và tại sao reasoning models là bước ngoặt của AI 2026.
Diffusion Models: Stable Diffusion, Midjourney & AI Tạo Ảnh 2026
Hiểu cách Diffusion Models hoạt động — công nghệ đằng sau Stable Diffusion, Midjourney, DALL-E. Từ khử nhiễu đến tạo ảnh chất lượng cao.
AI Edge Computing: Chạy AI Trên Thiết Bị Không Cần Cloud 2026
Hướng dẫn toàn tập về AI Edge Computing - chạy mô hình AI trực tiếp trên smartphone, laptop, IoT mà không phụ thuộc cloud. So sánh on-device vs cloud AI, công nghệ quantization, NPU, và các framework như MediaPipe, TensorFlow Lite.
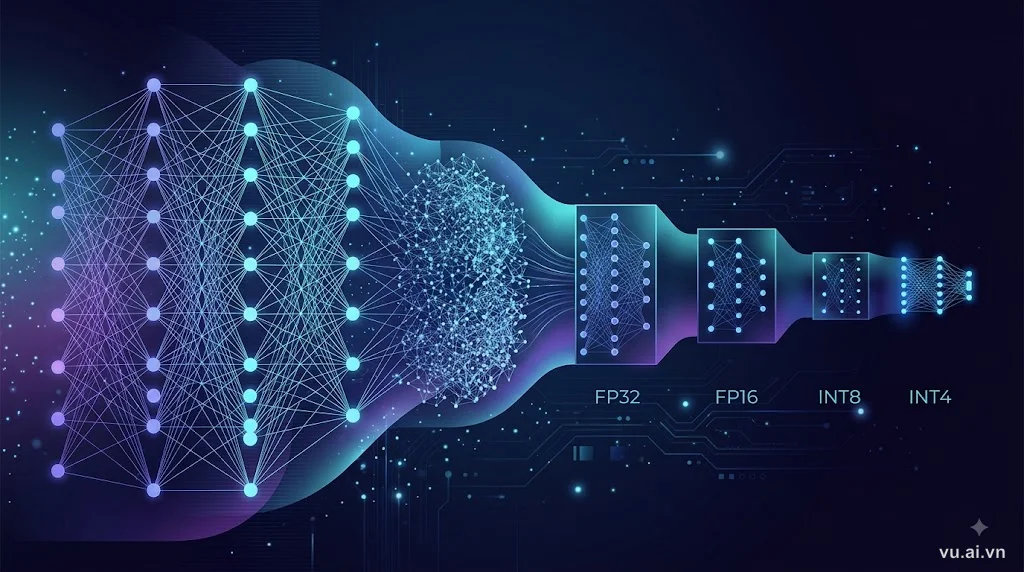
Quantization Trong AI: Giảm Kích Thước Model 10 Lần Mà Vẫn Giữ Chất Lượng
Quantization giúp giảm kích thước mô hình AI từ 32GB xuống 3GB mà vẫn giữ 95%+ độ chính xác. Hướng dẫn chi tiết FP16, INT8, INT4 và công cụ thực hành 2026.
RLHF: Cách AI Học Từ Phản Hồi Của Con Người
RLHF là kỹ thuật huấn luyện AI bằng cách thu thập phản hồi từ con người để mô hình ngôn ngữ lớn trở nên hữu ích, an toàn và phù hợp với ý định thực tế.
Vision AI & Nhận Diện Hình Ảnh: Từ OCR Đến Object Detection 2026
Computer Vision và Vision AI đang thay đổi cách máy móc nhìn thế giới. Tìm hiểu OCR, nhận diện khuôn mặt, object detection và cách áp dụng thực tế.
AI Voice & Speech Recognition: TTS và STT Năm 2026
Tổng quan công nghệ AI giọng nói: Text-to-Speech, Speech-to-Text, ứng dụng thực tế và so sánh các công cụ phổ biến năm 2026.
Function Calling & Tool Use: Khi AI Biết Gọi API và Dùng Công Cụ
Function calling cho phép AI tương tác với hệ thống bên ngoài, từ gọi API đến điều khiển thiết bị. Tìm hiểu cách hoạt động và ứng dụng thực tế.
Multimodal AI: Khi AI Hiểu Cả Text, Hình Ảnh và Giọng Nói
Multimodal AI kết hợp text, hình ảnh, giọng nói, video trong một mô hình thống nhất. Tìm hiểu cách công nghệ này hoạt động và ứng dụng thực tế 2026.
Prompt Engineering: Viết Lệnh Để AI Hiểu Bạn
Kỹ năng viết prompt tốt giúp bạn khai thác tối đa sức mạnh của ChatGPT, Claude, Gemini. Hướng dẫn từ cơ bản đến nâng cao cho người Việt 2026.
Xây Chatbot AI Riêng Cho Website: Hướng Dẫn Từ A-Z
Hướng dẫn chi tiết cách xây dựng chatbot AI riêng cho website của bạn - từ chọn công nghệ, thiết kế hội thoại đến triển khai thực tế.
Bảo Mật & Riêng Tư Khi Dùng AI: Điều Cần Biết Năm 2026
Hướng dẫn toàn diện về bảo mật dữ liệu cá nhân khi sử dụng ChatGPT, Claude, Gemini và các AI khác. Rủi ro, giải pháp, và cách bảo vệ thông tin của bạn.
Ứng Dụng AI Trong Sáng Tạo Nội Dung YouTube Hiệu Quả 2026
Hướng dẫn chi tiết cách dùng AI để tạo nội dung YouTube — từ ý tưởng, kịch bản, thumbnail, lồng tiếng đến tối ưu SEO. Workflow thực tế cho creator Việt.
Mô Hình Ngôn Ngữ Lớn (LLM) Hoạt Động Thế Nào?
Khám phá cách ChatGPT, Claude và các LLM khác xử lý ngôn ngữ — từ kiến trúc Transformer đến quá trình training và inference.
Embeddings & Vector Database: Nền Tảng Của AI Hiểu Ngữ Nghĩa
Embeddings biến văn bản thành vector số để AI hiểu ngữ nghĩa. Vector database tìm kiếm siêu nhanh - nền tảng của RAG, chatbot và tìm kiếm thông minh.
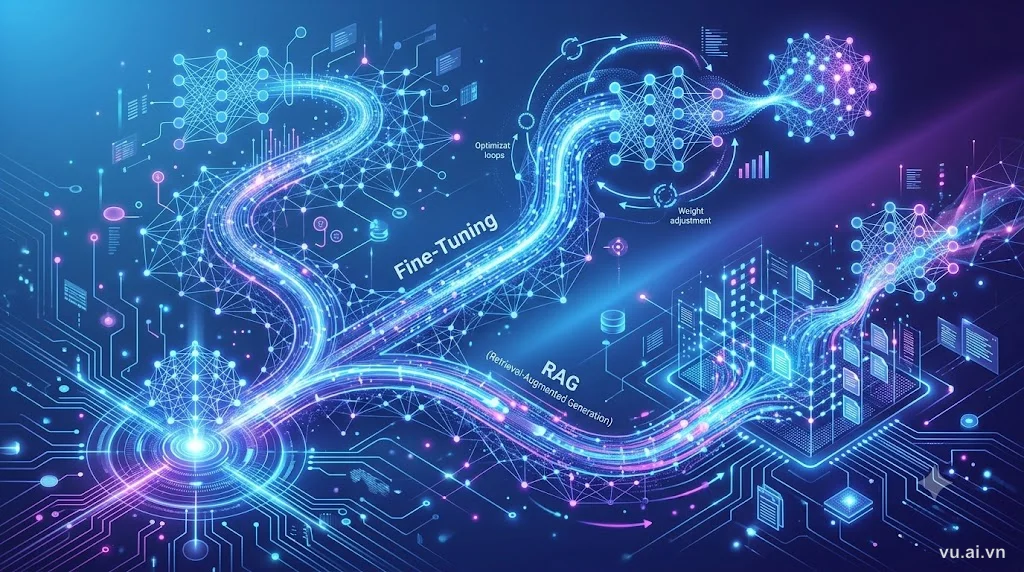
Fine-tuning Hay RAG? Khi Nào Dùng Cái Nào
So sánh Fine-tuning vs RAG — hai cách nâng cấp mô hình AI. Hiểu rõ ưu nhược điểm và quyết định phương pháp phù hợp với dự án của bạn.
AI Tạo Sinh (Generative AI): Toàn Cảnh Cho Người Việt 2026
Generative AI là gì? Cách hoạt động, ứng dụng thực tế, mô hình GPT/DALL-E/Sora và xu hướng 2026. Hướng dẫn toàn cảnh cho người Việt mới bắt đầu.
Chạy LLM local: dùng AI ngay trên máy, không cần internet
Hướng dẫn dễ hiểu về chạy mô hình ngôn ngữ lớn (LLM) ngay trên máy cá nhân — ưu nhược điểm, công cụ phổ biến như Ollama, và ai nên dùng.
Context window là gì? 'Trí nhớ ngắn hạn' của AI
Context window là lượng thông tin tối đa mà mô hình AI có thể 'nhìn thấy' cùng lúc khi trả lời. Giải thích dễ hiểu về token, giới hạn và mẹo dùng hiệu quả.
MCP (Model Context Protocol) là gì? Cổng kết nối chuẩn cho AI
MCP là giao thức mở giúp AI kết nối với công cụ, dữ liệu và dịch vụ bên ngoài theo một chuẩn chung — ví như 'cổng USB-C' cho thế giới AI. Giải thích dễ hiểu cho người mới.
Prompt engineering cơ bản: nghệ thuật ra lệnh cho AI
Cùng một câu hỏi, cách bạn diễn đạt quyết định chất lượng câu trả lời của AI. Học các kỹ thuật viết prompt nền tảng để dùng AI hiệu quả hơn nhiều lần.
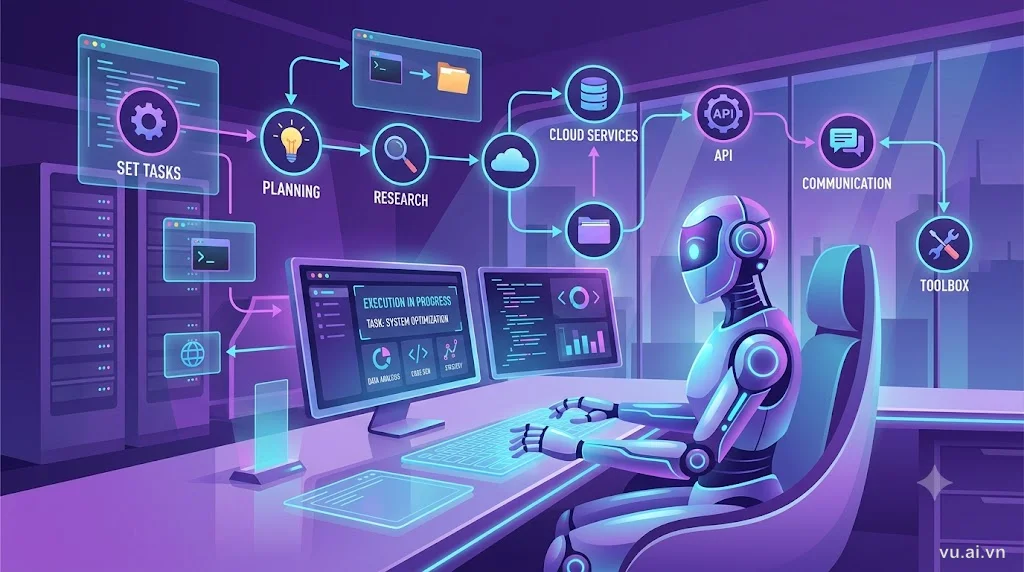
AI Agent là gì và vì sao nó quan trọng
Tổng quan dễ hiểu về AI Agent — cách chúng hoạt động và ứng dụng thực tế trong công việc.