AI Gateway & Model Router: Quản Lý Nhiều LLM Thông Minh 2026
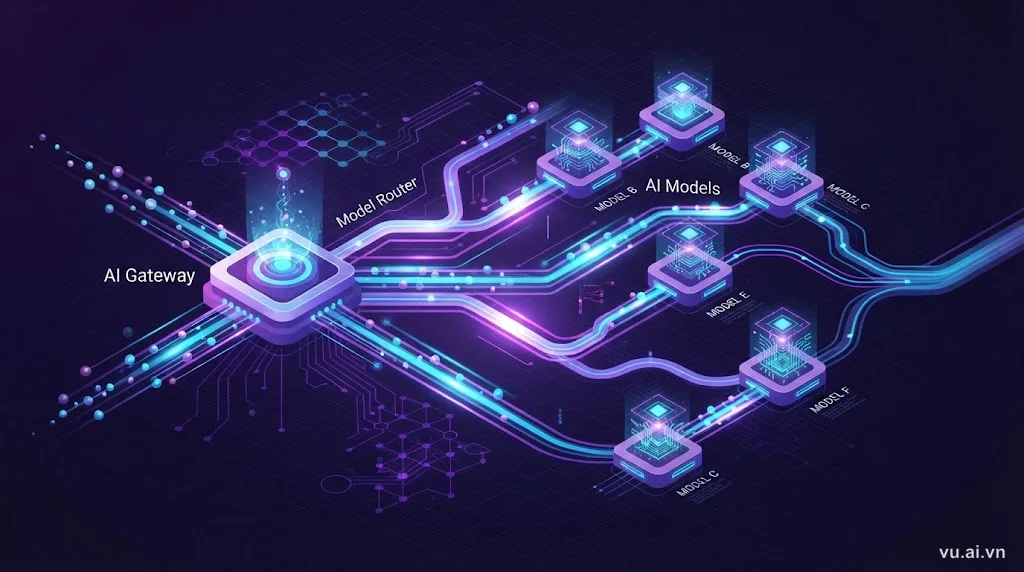
Bạn đang dùng nhiều model AI khác nhau — GPT-4 cho phân tích, Claude cho viết lách, Gemini cho tìm kiếm?
Mỗi lần gọi API phải nhớ format khác nhau. Key riêng. Pricing riêng. Một ngày nọ OpenAI timeout, cả hệ thống đứng im. Đó là lúc bạn cần AI Gateway.
AI Gateway (còn gọi là Model Router hay LLM Proxy) đóng vai trò trung gian thông minh giữa ứng dụng và các nhà cung cấp AI. Nó chuẩn hóa API, tự động retry, chuyển sang model dự phòng khi cần và theo dõi chi phí realtime. Năm 2026, đây không còn là “nice to have” cho doanh nghiệp lớn. Bất kỳ ai xây app AI đều nên có một gateway.
AI Gateway Là Gì?
AI Gateway là một lớp proxy nằm giữa ứng dụng của bạn và các nhà cung cấp AI (OpenAI, Anthropic, Google, Azure…). Thay vì app gọi trực tiếp từng provider, nó gọi gateway — gateway sẽ lo việc routing, retry, caching, logging và billing.
Về cơ bản, gateway biến đống API lộn xộn thành một giao diện thống nhất. Bạn viết code một lần theo chuẩn OpenAI, nhưng phía sau có thể chạy Claude, Gemini hay bất kỳ model nào — chỉ cần đổi config.
Tại Sao Cần AI Gateway?
Không có gateway:
- Code riêng cho từng provider (OpenAI SDK này, Anthropic SDK kia)
- Timeout từ một provider → app crash
- Không biết đang tốn bao nhiêu tiền cho model nào
- Muốn thử model mới phải refactor code
Có gateway:
- Một API thống nhất cho tất cả model
- Tự động fallback khi model chính lỗi
- Dashboard realtime theo dõi cost, latency, success rate
- A/B test model mới chỉ bằng vài dòng config
Tóm gọn? Gateway giúp hệ thống AI ổn định hơn, rẻ hơn và linh hoạt hơn. Đơn giản vậy.
Các Tính Năng Quan Trọng
1. Model Routing Thông Minh
Gateway quyết định gửi request tới model nào dựa trên:
- Load balancing: phân đều traffic giữa nhiều key/endpoint
- Cost optimization: chọn model rẻ nhất đủ điều kiện
- Latency priority: ưu tiên model phản hồi nhanh
- Semantic routing: phân loại câu hỏi và gửi tới model chuyên môn
Ví dụ: câu hỏi đơn giản gửi GPT-3.5, phức tạp gửi GPT-4, code gửi Claude Sonnet, tìm kiếm gửi Gemini với grounding.
2. Fallback & Retry
Model chính timeout hoặc rate limit? Gateway tự động:
- Retry với exponential backoff
- Chuyển sang model dự phòng
- Thử nhiều key luân phiên
Người dùng không thấy lỗi.
Ứng dụng vẫn hoạt động.
3. Caching Thông Minh
Gateway cache response theo:
- Exact match: query giống hệt → trả cache
- Semantic cache: query tương tự nghĩa → trả cache (tiết kiệm 70-90% cost)
- TTL linh hoạt: data tĩnh cache lâu, realtime cache ngắn
Một query phổ biến chỉ gọi API thật một lần, 100 request sau đọc cache — chi phí giảm gần như bằng không.
4. Observability & Analytics
Dashboard realtime hiển thị:
- Chi phí từng model, từng user, từng feature
- Latency p50/p95/p99
- Success rate, error breakdown
- Token usage trends
Bạn biết chính xác feature nào đang tốn tiền, model nào chậm, user nào abuse.
5. Rate Limiting & Quota
Giới hạn:
- Request per minute/hour/day
- Token quota per user/team
- Cost cap tự động
Ngăn user bất cẩn tốn hết budget trong một đêm.
Các Giải Pháp AI Gateway Phổ Biến
LiteLLM Proxy
Open-source, tự host, miễn phí.
LiteLLM là gateway Python phổ biến nhất, hỗ trợ hơn 100 model provider. Cài đặt trong 5 phút:
pip install litellm[proxy]
litellm --config config.yaml
Config đơn giản:
model_list:
  - model_name: gpt-4
    litellm_params:
      model: openai/gpt-4
      api_key: sk-...
  - model_name: gpt-4  # fallback
    litellm_params:
      model: azure/gpt-4
      api_key: ...
Ứng dụng gọi LiteLLM endpoint như OpenAI API. Gateway tự động routing, retry, logging.
Ưu điểm: miễn phí, dễ setup, cộng đồng lớn, hỗ trợ đầy đủ model.
Nhược điểm: UI cơ bản, analytics đơn giản, cần tự vận hành infrastructure.
Portkey
Managed service, có free tier.
Portkey là gateway cloud chuyên nghiệp với dashboard đẹp, analytics chi tiết, semantic caching và AI Gateway Firewall (bảo vệ khỏi prompt injection).
Setup chỉ cần add header:
openai.api_base = "https://api.portkey.ai/v1"
openai.default_headers = {"x-portkey-api-key": "..."}
Config routing bằng UI hoặc JSON. Portkey tự động fallback, cache, log mọi request.
Ưu điểm: không cần vận hành, UI/UX tốt, tính năng bảo mật cao, semantic cache mạnh.
Nhược điểm: có phí (free tier 10k requests/tháng), phụ thuộc bên thứ ba.
Cloudflare AI Gateway
Miễn phí, tích hợp Cloudflare Workers.
Nếu bạn đã dùng Cloudflare, AI Gateway tích hợp sẵn. Cache, analytics, rate limiting — tất cả chạy trên edge toàn cầu.
// Workers endpoint
fetch("https://gateway.ai.cloudflare.com/v1/{account}/{gateway}/openai", {
  method: "POST",
  headers: { "Authorization": "Bearer sk-..." },
  body: JSON.stringify({ model: "gpt-4", messages: [...] })
})
Ưu điểm: miễn phí, latency cực thấp (edge), tích hợp Workers.
Nhược điểm: tính năng cơ bản, ít tùy biến, chỉ hỗ trợ một số provider lớn.
Azure API Management
Doanh nghiệp, tích hợp Azure.
Azure APIM quản lý API gateway cho Azure OpenAI, bao gồm routing, throttling, logging. Phù hợp nếu toàn bộ stack của bạn ở Azure.
Ưu điểm: tích hợp sâu Azure, bảo mật enterprise, compliance cao.
Nhược điểm: phức tạp, đắt, chỉ tối ưu cho Azure ecosystem.
Xây Dựng AI Gateway Riêng
Nếu bạn cần kiểm soát tối đa hoặc có logic routing phức tạp, tự xây gateway không khó:
Stack đơn giản:
- Proxy layer: Node.js/Python server
- Routing logic: config-driven hoặc rule-based
- Cache: Redis với semantic similarity search
- Logging: Postgres hoặc ClickHouse
- Monitoring: Prometheus + Grafana
Flow cơ bản:
- App gửi request → Gateway
- Gateway check cache (exact hoặc semantic)
- Nếu miss, routing tới provider (OpenAI/Claude/Gemini)
- Retry nếu fail, fallback nếu cần
- Log request/response/cost
- Cache kết quả
- Trả về app
Một implementation Node.js đơn giản có thể chỉ ~300 dòng code. Thêm Redis caching và Postgres logging, bạn đã có gateway production-ready.
Khi nào nên tự xây:
- Routing logic độc quyền (ví dụ: chọn model dựa trên profile người dùng)
- Cần kiểm soát toàn bộ data (compliance, privacy)
- Muốn tích hợp sâu với hệ thống nội bộ
- Budget cho managed service không hợp lý
Khi nào nên dùng sẵn:
- Cần nhanh, không muốn vận hành infrastructure
- Team nhỏ, ưu tiên tập trung vào product
- Không có yêu cầu routing đặc biệt
Best Practices Khi Dùng AI Gateway
1. Luôn Có Fallback Model
Config tối thiểu 2 provider cho mỗi use case. Nếu OpenAI down, chuyển sang Anthropic. Nếu cả hai down (hiếm nhưng đã xảy ra), trả lỗi rõ ràng thay vì crash im lìm.
2. Set Budget Alert
Đặt cost cap và alert khi đạt 50%, 80%, 100% ngân sách. Gateway giám sát realtime, bạn không bao giờ bị “surprise billing” 10 triệu đô như những ai đã từng để lộ API key.
3. Log Đầy Đủ Nhưng An Toàn
Log request/response để debug, nhưng:
- Mask thông tin nhạy cảm (PII, credentials)
- Tuân thủ GDPR/retention policy
- Tách biệt log production và development
4. Monitor Latency Per Model
Mỗi model có latency khác nhau. Theo dõi p95 latency và tự động chuyển sang model nhanh hơn nếu SLA bị vi phạm.
5. A/B Test Model Trước Khi Migrate
Muốn thử model mới? Routing 5% traffic qua model đó, so sánh quality/cost/latency. Nếu tốt hơn, tăng dần lên 100%. Gateway cho phép experiment an toàn.
Chi Phí & ROI
Managed gateway (Portkey/Cloudflare):
- Free tier: đủ cho MVP/side project
- Paid: thường $99-299/tháng hoặc % revenue
- ROI: tiết kiệm chi phí API 30-70% nhờ cache + routing thông minh
Self-hosted (LiteLLM):
- Server cost: $20-100/tháng (VPS hoặc serverless)
- Dev time: 2-5 ngày setup ban đầu
- ROI: tiết kiệm 50-90% so sánh gọi trực tiếp (nhờ cache, cheap model routing)
Một công ty trung bình tốn $5000/tháng cho OpenAI. Thêm gateway với semantic cache, họ giảm còn $2000. Gateway tự trả tiền thuê chỉ sau 1 tháng.
Khi Nào Bạn Thực Sự Cần AI Gateway?
CẦN ngay:
- Bạn dùng ≥2 model provider
- Chi phí AI >$500/tháng
- Downtime một provider ảnh hưởng nghiêm trọng
- Cần kiểm soát cost chi tiết
CÓ THỂ CHƯA CẦN:
- MVP với 1 model, <100 requests/ngày
- App nội bộ, downtime chấp nhận được
- Chưa tối ưu cost (cache app-level đủ)
Nhưng ngay cả khi chưa cần, setup sớm giúp bạn tránh refactor lớn sau này.
Tương Lai AI Gateway
Năm 2026 và xa hơn:
Semantic routing nâng cao: Gateway phân tích query và tự động chọn model tốt nhất (không cần rule thủ công). Câu hỏi về code → Claude, về tìm kiếm → Gemini, về reasoning → GPT-o1.
Cross-provider optimization: Gateway tự động thử nhiều model song song, chọn response tốt nhất hoặc blend nhiều answer (ensemble).
Privacy-preserving gateway: Encrypt request trước khi gửi provider, họ không thấy data thật. Homomorphic encryption hoặc federated learning ngay trong gateway.
Model marketplace: Gateway tích hợp kho model mở, tự động discover và test model mới (Hugging Face, Replicate…). Bạn không cần follow từng release — gateway tự cập nhật.
Gateway đang chuyển từ “proxy đơn thuần” sang “AI operations platform” — nơi quản lý toàn bộ vòng đời model từ routing đến monitoring, testing, optimization.
Kết Luận
AI Gateway không phải là “nice to have” — nó là điều kiện cần để vận hành AI production. Chi phí setup thấp (thậm chí miễn phí), nhưng ROI cực cao: hệ thống ổn định hơn, rẻ hơn, linh hoạt hơn.
Nếu bạn mới bắt đầu: thử LiteLLM hoặc Cloudflare AI Gateway — cả hai đều miễn phí và dễ setup. Nếu cần managed service chuyên nghiệp: Portkey là lựa chọn tốt với free tier hào phóng.
Đừng chờ đến khi OpenAI timeout lúc 2h sáng mới nghĩ đến gateway. Setup từ đầu, ngủ ngon hơn.
Đọc thêm:
- Semantic Caching Trong LLM: Tiết Kiệm 90% Chi Phí API AI — cách cache thông minh giúp giảm cost, kỹ thuật core trong gateway
- AI Observability: Giám Sát & Debug AI Model Trong Production 2026 — monitoring và logging cho hệ thống AI, phần quan trọng của gateway
- Streaming AI Responses: Trải Nghiệm Realtime Với LLM 2026 — streaming qua gateway, cải thiện UX khi dùng nhiều model


