Transformer Architecture & Attention Mechanism: Nền Tảng Kỹ Thuật Của Mọi LLM 2026
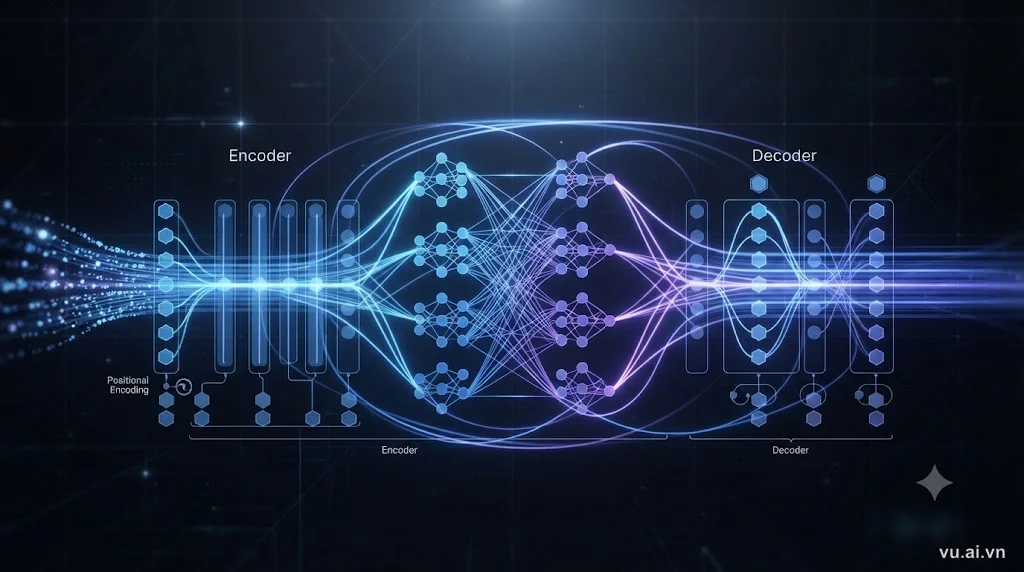
Transformer là kiến trúc nền tảng của mọi mô hình ngôn ngữ lớn hiện đại — từ GPT-4, Claude, đến Gemini. Bài này giải mã cách Attention Mechanism giúp AI “hiểu” ngữ cảnh, tại sao Transformer lại thay thế hoàn toàn RNN/LSTM, và các kỹ thuật tối ưu đang định hình tương lai AI.
Nếu bạn từng thắc mắc “ChatGPT hiểu câu dài thế nào mà không quên ngữ cảnh?”, câu trả lời nằm ở đây.
Transformer Là Gì Và Tại Sao Quan Trọng?
Transformer là một kiến trúc mạng neural được công bố năm 2017 trong paper “Attention Is All You Need” (Google Brain). Nó đánh dấu bước ngoặt lịch sử AI: lần đầu tiên một mô hình xử lý chuỗi (sequence) không cần RNN hay LSTM, chỉ dựa vào cơ chế Attention.
Tại sao Transformer lại “giết chết” RNN/LSTM?
- RNN/LSTM xử lý tuần tự (từ → từ), không song song được → chậm, khó train với dữ liệu lớn.
- Vanishing gradient khiến RNN quên ngữ cảnh xa (câu dài >100 từ thường mất mạch).
- Transformer xử lý song song toàn bộ câu cùng lúc, tính toán mối quan hệ giữa mọi cặp từ → nhanh hơn 10-100 lần, hiểu ngữ cảnh dài hơn (GPT-4 đọc được 128k token).
Kết quả: Mọi LLM từ 2018 đến nay — GPT, BERT, T5, Claude, Gemini — đều dựng trên Transformer.
Attention Mechanism Hoạt Động Như Thế Nào?
Attention (Chú ý) là cách mô hình quyết định từ nào trong câu quan trọng nhất để hiểu từ hiện tại.
Ví dụ minh họa
Câu: “Con mèo của tôi rất thông minh, nó biết mở cửa.”
Khi mô hình đọc từ “nó”, Attention sẽ:
- Tính điểm liên quan (attention score) giữa “nó” và mọi từ trước đó.
- Phát hiện “nó” liên quan mạnh nhất với “mèo” (cao hơn “tôi”, “cửa”).
- Dùng thông tin từ “mèo” để hiểu “nó” = con mèo.
Self-Attention là kỹ thuật Transformer dùng để tính toán này — mỗi từ “nhìn” tất cả các từ khác và quyết định ai quan trọng bao nhiêu.
Ba ma trận: Query, Key, Value (Q, K, V)
Self-Attention biến mỗi từ thành 3 vector:
- Query (Q): “Tôi đang tìm thông tin gì?”
- Key (K): “Tôi chứa thông tin gì?”
- Value (V): “Nội dung thông tin của tôi là gì?”
Công thức:
Attention(Q, K, V) = softmax(Q·Kᵀ / √d) × V
Q·Kᵀ: tính độ tương đồng (từ nào liên quan với từ nào).√d: chuẩn hóa (tránh giá trị quá lớn).softmax: chuyển thành xác suất (tổng = 1).× V: lấy thông tin từ các từ quan trọng.
Kết quả: Mỗi từ nhận được thông tin tổng hợp từ toàn bộ câu, trọng số theo mức độ liên quan.
Multi-Head Attention: Nhìn Nhiều Góc Độ Cùng Lúc
Một lớp Attention có thể bỏ sót chi tiết. Transformer dùng Multi-Head Attention — chạy 8-16 lớp Attention song song, mỗi lớp học một khía cạnh khác nhau:
- Head 1 học quan hệ chủ-vị (ai làm gì).
- Head 2 học quan hệ tính từ-danh từ.
- Head 3 học ngữ cảnh xa (từ cách 20 vị trí).
- …
Cuối cùng, kết quả của các head được nối lại (concatenate) và chiếu qua một lớp linear.
Lợi ích: Mô hình hiểu câu đa chiều — vừa nắm cú pháp, vừa hiểu ngữ nghĩa, vừa nhớ ngữ cảnh xa.
Kiến Trúc Transformer: Encoder-Decoder
Transformer gốc (2017) gồm 2 phần:
Encoder (Bộ mã hóa)
- Đọc câu đầu vào, tạo biểu diễn ngữ cảnh.
- Dùng cho: BERT, RoBERTa (hiểu văn bản — classification, NER, Q&A).
- Self-Attention giữa tất cả các từ (bidirectional — nhìn cả trước và sau).
Decoder (Bộ giải mã)
- Sinh câu đầu ra, từng từ một.
- Dùng cho: GPT, Claude, Gemini (tạo văn bản).
- Masked Self-Attention (chỉ nhìn các từ trước đó, không nhìn tương lai) + Cross-Attention (lấy thông tin từ encoder nếu có).
GPT chỉ dùng Decoder (autoregressive — sinh từ kế tiếp dựa vào các từ trước). BERT chỉ dùng Encoder. T5/BART dùng cả hai.
Positional Encoding: Transformer Nhớ Thứ Tự Từ Thế Nào?
Vì Transformer xử lý song song (không tuần tự như RNN), nó không biết thứ tự từ. Để khắc phục, Transformer cộng thêm Positional Encoding (mã hóa vị trí) vào mỗi từ:
PE(pos, 2i)   = sin(pos / 10000^(2i/d))
PE(pos, 2i+1) = cos(pos / 10000^(2i/d))
pos: vị trí từ (0, 1, 2, …).i: chiều (dimension) trong vector.- Kết quả: mỗi vị trí có một “dấu vân tay” duy nhất, mô hình học được “từ này đứng trước/sau từ kia”.
Các biến thể mới (GPT-3, Claude) dùng Learned Positional Embeddings hoặc Rotary Positional Embedding (RoPE) — hiệu quả hơn với context dài.
Feed-Forward Network: Xử Lý Phi Tuyến
Sau mỗi lớp Attention, Transformer chạy qua một Feed-Forward Network (FFN):
FFN(x) = ReLU(xW₁ + b₁)W₂ + b₂
FFN là một mạng neural 2 lớp, chạy độc lập trên mỗi vị trí (không chia sẻ thông tin giữa các từ). Nhiệm vụ:
- Biến đổi phi tuyến (học pattern phức tạp).
- Khuếch đại chiều (inner layer thường 4× lớn hơn) rồi chiếu lại.
Tại sao cần FFN khi đã có Attention? Attention học quan hệ, FFN học biến đổi — hai vai trò bổ trợ.
Residual Connection & Layer Normalization: Giữ Ổn Định Khi Train Sâu
Transformer có 12-96 lớp (GPT-4 ước ~120 lớp). Train sâu dễ bị gradient explode/vanish. Giải pháp:
-
Residual Connection:
output = LayerNorm(x + Attention(x))
output = LayerNorm(output + FFN(output))
Cộng trực tiếp input vào output — gradient “chảy thẳng” qua các lớp, không bị mất.
-
Layer Normalization: Chuẩn hóa output mỗi lớp (mean=0, std=1) → ổn định training.
Kết quả: Transformer có thể train lên hàng trăm lớp mà không sập.
Tại Sao Transformer Mở Ra Kỷ Nguyên LLM?
Trước Transformer, mô hình ngôn ngữ tốt nhất (LSTM-based) chỉ train được với vài triệu tham số, context ~1000 từ. Transformer thay đổi game:
- Song song hóa hoàn toàn → train nhanh gấp 10-100 lần → scale lên tỷ tham số.
- Context dài (GPT-4: 128k token) → hiểu ngữ cảnh sách/report.
- Transfer learning dễ dàng → pre-train trên text khổng lồ, fine-tune cho task cụ thể.
Timeline:
- 2017: Transformer ra đời.
- 2018: BERT (Encoder), GPT-1 (Decoder) chứng minh sức mạnh.
- 2019: GPT-2 (1.5B params) viết văn “như người”.
- 2020: GPT-3 (175B params) few-shot learning.
- 2023-2026: GPT-4, Claude 3, Gemini 1.5 — trợ lý AI toàn năng.
Không có Transformer, không có ChatGPT.
Các Kỹ Thuật Tối Ưu Attention Hiện Đại
Attention chuẩn có độ phức tạp O(n²) (n = độ dài câu) → tốn VRAM khủng với context dài. Các cải tiến:
Sparse Attention
Thay vì tính toán toàn bộ n×n, chỉ tính một phần (ví dụ: chỉ chú ý 512 token gần nhất). Dùng trong Longformer, BigBird.
Flash Attention
Tối ưu I/O giữa GPU SRAM và HBM — giảm 3-5× thời gian, dùng ít VRAM hơn 50%. GPT-4, Claude đều dùng.
Grouped-Query Attention (GQA)
Llama 2, Gemini dùng — chia nhỏ số head (ví dụ: 8 query heads chia sẻ 2 key/value heads) → giảm 40% VRAM inference, tốc độ tăng 2×.
Multi-Query Attention (MQA)
PaLM, Falcon dùng — 1 key/value cho tất cả query heads → cực nhanh, nhưng mất một chút chất lượng.
So sánh:
| Kỹ thuật | Tốc độ | Chất lượng | Dùng ở đâu |
|---|---|---|---|
| Standard Attention | Chậm | Tốt nhất | GPT-3 |
| MQA | Rất nhanh | Giảm nhẹ | Falcon, PaLM |
| GQA | Nhanh | Gần bằng standard | Llama 2, Gemini |
| Flash Attention | 3-5× nhanh | Bằng standard | GPT-4, Claude |
Hạn Chế Của Transformer Và Hướng Nghiên Cứu Mới
Dù mạnh, Transformer không hoàn hảo:
-
Context length bị giới hạn: dù GPT-4 lên 128k, vẫn chưa thể đọc cả cuốn sách 500 trang (~1.5M tokens). Hướng giải quyết: Recurrent Memory Transformer, State Space Models (SSM) như Mamba.
-
Thiếu suy luận tuần tự: Attention “nhìn” song song, không “suy nghĩ từng bước” như người. Giải pháp: Chain-of-Thought prompting, Reasoning models (GPT-o1, DeepSeek-R1).
-
Tốn tài nguyên: train GPT-4 ước ~$100M. Giải pháp: Mixture of Experts (MoE), quantization, SLM nhỏ gọn.
-
Hallucination: Transformer sinh text “trơn” nhưng đôi khi bịa. Giải pháp: RAG, grounding, RLHF.
Tương Lai: Transformer Hay Kiến Trúc Mới?
Transformer vẫn thống trị (2026), nhưng các kiến trúc mới đang nổi lên:
- State Space Models (SSM): Mamba, RWKV — xử lý tuyến tính O(n) thay vì O(n²), context không giới hạn. Chưa vượt Transformer về chất lượng, nhưng rất hứa hẹn.
- Hybrid: kết hợp Transformer (hiểu sâu) + RNN/SSM (nhớ dài) — ví dụ: RETRO (DeepMind).
- Sparse MoE Transformer: GPT-4 ước dùng MoE — kích hoạt chỉ 10-20% model mỗi lần, vừa lớn vừa nhanh.
Dự đoán: Transformer sẽ còn dẫn đầu ít nhất 3-5 năm nữa, nhưng kiến trúc thế hệ sau sẽ kết hợp ưu điểm của nhiều hướng.
Cách Học Transformer Từ Cơ Bản Đến Nâng Cao
Bước 1: Hiểu Attention (đọc paper “Attention Is All You Need”, implement self-attention từ đầu bằng NumPy).
Bước 2: Code mini-Transformer (PyTorch/TensorFlow, train trên task đơn giản như dịch máy).
Bước 3: Đọc code GPT-2 (OpenAI mở nguồn — 700 dòng, rất sạch).
Bước 4: Thử các biến thể (BERT, T5, Llama) — so sánh encoder-only vs decoder-only.
Bước 5: Tối ưu — áp Flash Attention, GQA, quantization.
Tài nguyên:
- Paper gốc: arxiv.org/abs/1706.03762
- Annotated Transformer (Harvard NLP): nlp.seas.harvard.edu/annotated-transformer
- GPT-2 code: github.com/openai/gpt-2
Kết Luận
Transformer không chỉ là một kiến trúc — nó là nền tảng của cuộc cách mạng AI 2020s. Hiểu Transformer = hiểu cách GPT viết code, Claude phân tích, Gemini tạo ảnh.
Nếu bạn làm AI, học Transformer không phải “nên” mà là bắt buộc. Nếu bạn chỉ dùng AI, biết cơ chế Attention giúp bạn viết prompt tốt hơn — vì bạn hiểu mô hình “chú ý” vào đâu.
3 điểm mấu chốt cần nhớ:
- Attention = cách mô hình “nhìn” toàn bộ câu và quyết định phần nào quan trọng.
- Multi-head = nhiều góc nhìn song song → hiểu đa chiều.
- Transformer = song song hóa → nhanh → scale → LLM hiện đại.
Transformer đã mở ra kỷ nguyên AI thông minh. Hiểu nó = hiểu tương lai.
Đọc thêm:
- Mô Hình Ngôn Ngữ Lớn (LLM) Hoạt Động Thế Nào? — nếu bạn muốn hiểu tổng quan cách LLM học và sinh text, từ tokenization đến training, bài này là điểm khởi đầu hoàn hảo.
- Chain-of-Thought & Reasoning AI: O1, DeepSeek-R1 và Tương Lai Suy Luận — Transformer sinh text mượt, nhưng để “suy nghĩ” như người, cần thêm Chain-of-Thought — đọc để thấy Attention chưa đủ với bài toán phức tạp.
- Mixture of Experts (MoE): Bí Mật LLM Khổng Lồ Nhưng Nhanh 2026 — GPT-4 và Gemini nghi dùng MoE để scale Transformer lên hàng nghìn tỷ tham số mà vẫn chạy nhanh — cách họ vượt qua giới hạn O(n²) của Attention.


