Model Distillation: Chưng Cất AI Từ Lớn Thành Nhỏ Mà Vẫn Thông Minh
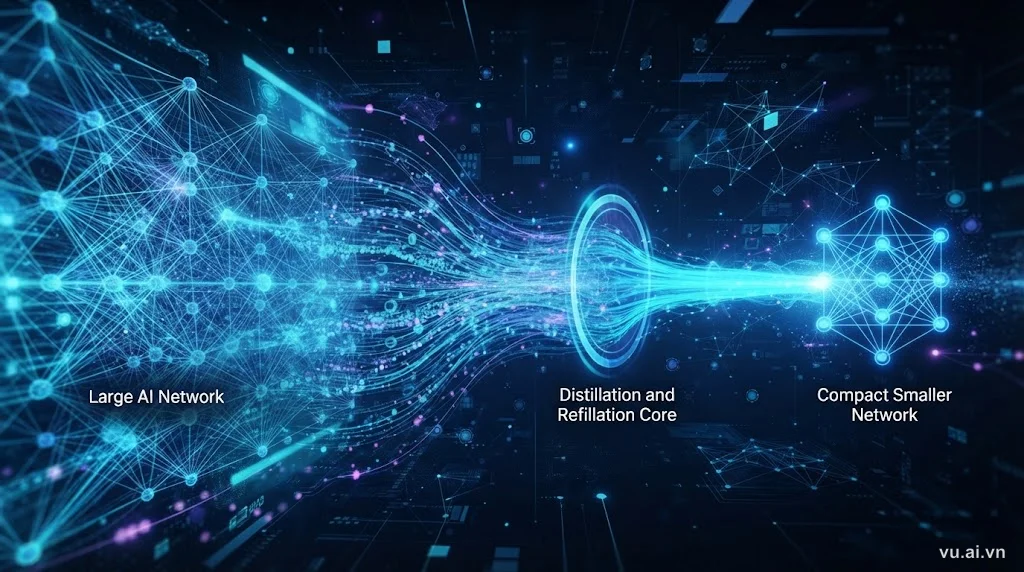
Model distillation (chưng cất mô hình) là kỹ thuật nén AI — bạn huấn luyện một model nhỏ (student) học từ một model lớn (teacher), thu được model chạy nhanh hơn 5-10 lần, nhẹ hơn 90%, nhưng vẫn giữ 95-98% độ chính xác ban đầu. Đây là bí quyết đằng sau nhiều ứng dụng AI realtime: chatbot trên mobile, nhận diện giọng nói edge device, tự động hóa content — nơi tốc độ và chi phí quan trọng không kém accuracy.
Model Distillation Là Gì?
Model distillation (chưng cất mô hình) là quá trình “truyền kiến thức” từ một model AI lớn, phức tạp (teacher model) sang một model nhỏ gọn hơn (student model).
Thay vì train student model từ đầu với raw data, bạn để nó học từ output của teacher — cả hard label (kết quả cuối) lẫn soft label (xác suất phân phối của teacher trên toàn bộ class). Soft label chứa nhiều thông tin hơn: teacher model biết rằng “con mèo này 85% mèo, 10% chó, 5% cáo” thay vì chỉ nói “mèo”. Student model học từ phân phối xác suất này nên học nhanh hơn, chính xác hơn so với train từ scratch.
Kết quả: student model nhỏ hơn 5-10 lần, chạy nhanh hơn 5-10 lần, nhưng vẫn giữ 95-98% độ chính xác của teacher.
Tại Sao Distillation Lại Hiệu Quả?
Một model lớn học được nhiều thông tin trung gian (intermediate representations) mà data gốc không thể hiện trực tiếp.
Khi teacher model đưa ra soft probabilities, nó đang “giải thích” cách nó hiểu bài toán. Ví dụ: chữ “A” viết nghiêng trông hơi giống “R”, “dog breed X” có đặc điểm chồng lấn với “breed Y”. Student model học từ những gợi ý này nên không phải tự mày mò lại từ đầu.
Giống việc học từ một thầy giỏi thay vì tự đọc sách — bạn hiểu nhanh hơn vì thầy đã chắt lọc kinh nghiệm.
Teacher model thường được train với regularization, data augmentation, ensemble — tất cả gói gọn trong output. Student chỉ cần học output cuối, không cần lặp lại toàn bộ tricks đó.
Cách Thực Hiện Distillation: Quy Trình Cơ Bản
1. Chọn teacher model và student architecture
- Teacher: model lớn đã train xong, accuracy cao (ví dụ: GPT-3.5, BERT-large, ResNet-152).
- Student: architecture nhỏ hơn nhiều (ví dụ: GPT-mini, DistilBERT, MobileNet). Không nhất thiết phải cùng kiến trúc.
2. Sinh soft labels từ teacher
Đưa training data qua teacher model, lưu lại logits (giá trị trước softmax) hoặc soft probabilities (sau softmax với temperature scaling).
Temperature (T) là hyperparameter quan trọng:
- T=1 → xác suất chuẩn
- T>1 (ví dụ T=3-5) → làm mềm phân phối xác suất, các class phụ nổi rõ hơn
Công thức softmax có temperature:
p_i = exp(z_i / T) / Σ exp(z_j / T)
Temperature cao giúp student học được các “gợi ý” từ các class phụ (low-probability classes).
3. Train student với distillation loss
Student học từ hai tín hiệu:
- Hard loss: so sánh output của student với ground truth (label gốc) — cross-entropy thông thường
- Soft loss: so sánh soft probabilities của student và teacher — KL divergence hoặc MSE
Tổng loss:
Loss = α × L_hard + (1 - α) × L_soft
α thường chọn 0.1–0.3 (soft loss chiếm phần lớn).
4. Fine-tune và evaluate
Sau khi train, đánh giá student model trên validation/test set. Nếu accuracy còn thấp, có thể:
- Tăng capacity của student (thêm layer/params)
- Điều chỉnh α hoặc temperature
- Thêm intermediate-layer distillation (feature matching)
Các Biến Thể Distillation Nâng Cao
Feature-based distillation
Ngoài output cuối, student còn học từ intermediate layers của teacher. Bạn thêm loss để match các hidden representations ở mid-layer:
L_feature = MSE(student_hidden, teacher_hidden)
Phương pháp này hiệu quả với vision models (CNNs) và language models (transformers).
Attention distillation
Đối với Transformer, student học cách teacher attend (chú ý) vào các token nào — copy attention distribution từ teacher sang student. Điều này giúp student “hiểu” cách teacher đọc câu.
Self-distillation
Không cần teacher bên ngoài — model tự học từ ensemble của chính nó hoặc từ checkpoint trước đó. Kỹ thuật này giúp cải thiện model mà không cần model lớn hơn.
Khi Nào Nên Dùng Distillation?
Dùng distillation khi:
-
Bạn có teacher model lớn, chính xác, nhưng quá chậm cho production.
Ví dụ: GPT-4 quá đắt cho chatbot hàng triệu request/ngày → distill sang model 7B nhỏ hơn. -
Deploy AI lên edge device (mobile, IoT) với RAM/CPU giới hạn.
Ví dụ: nhận diện giọng nói realtime trên smartphone → distill model 500MB xuống 50MB. -
Muốn giảm chi phí inference 5-10 lần mà chấp nhận mất 2-5% accuracy.
Nhiều bài toán thực tế 95% accuracy đã đủ — không cần 99% nếu nó chậm gấp đôi. -
Kết hợp nhiều model lớn thành một student gọn hơn (ensemble distillation).
Thay vì chạy 5 teacher models cùng lúc, train student học từ cả 5 → inference chỉ cần 1 model.
Không nên dùng distillation khi:
- Task quá phức tạp, teacher còn struggle. Student sẽ còn tệ hơn. Lúc này cần cải thiện teacher trước.
- Bạn cần 100% accuracy (medical diagnosis, critical safety) — không chấp nhận trade-off.
- Student architecture quá nhỏ (10x nhỏ hơn teacher). Gap quá lớn, distillation kém hiệu quả.
Ví Dụ Thực Tế: DistilBERT
DistilBERT là ví dụ kinh điển của distillation trong NLP. Hugging Face distill BERT-base (110M params) xuống DistilBERT (66M params):
- Giảm 40% kích thước
- Nhanh hơn 60% khi inference
- Giữ 97% accuracy của BERT trên GLUE benchmark
Họ dùng triple loss:
- Distillation loss (KL divergence giữa soft outputs)
- Cosine embedding loss (match hidden states)
- Masked language modeling loss (task gốc của BERT)
Kết quả: DistilBERT trở thành lựa chọn phổ biến cho production NLP khi cần cân bằng giữa accuracy và tốc độ.
So Sánh Distillation Với Các Kỹ Thuật Nén Khác
| Kỹ Thuật | Cách Hoạt Động | Ưu Điểm | Nhược Điểm |
|---|---|---|---|
| Distillation | Train student model nhỏ học từ teacher lớn | Giữ accuracy cao, architecture linh hoạt | Cần teacher model sẵn, train lâu |
| Quantization | Giảm độ chính xác số (FP32→INT8) | Nhanh, dễ deploy, ít storage | Có thể mất accuracy 1-3% |
| Pruning | Loại bỏ weights/neurons không quan trọng | Giữ architecture ban đầu | Cần retrain, khó tune threshold |
| Low-rank factorization | Phân rã weight matrix thành tích 2 ma trận nhỏ | Giảm params hiệu quả | Phức tạp khi implement, kém linh hoạt |
Kết hợp cả bốn là chiến lược tối ưu: distill → prune → quantize → low-rank. Ví dụ: MobileNet V3 dùng neural architecture search (NAS) + distillation + quantization để chạy realtime trên smartphone.
Công Cụ & Framework Hỗ Trợ Distillation
- Hugging Face Transformers: hỗ trợ
DistilBERT,DistilGPT-2,DistilRoBERTa— có sẵn scripts distillation. - PyTorch:
torch.nn.KLDivLosscho soft loss, custom training loop dễ viết. - TensorFlow Model Optimization Toolkit: API cho pruning, quantization, và distillation.
- ONNX Runtime + Olive: pipeline optimization tự động (distill → quantize → export ONNX).
- OpenVINO: Intel framework cho edge deployment — hỗ trợ distillation + quantization.
Nếu bạn dùng open-source models (Llama, Mistral, Gemma), đã có community-distilled versions trên Hugging Face — ví dụ: distil-whisper (phiên bản nhỏ của Whisper ASR), TinyLlama (distill từ Llama-2).
Những Lưu Ý Khi Thực Hành Distillation
-
Chọn temperature đúng: T=3-5 thường hoạt động tốt với classification, T=1-2 cho regression. Thử nghiệm nhiều giá trị.
-
Student không quá nhỏ: nếu student có <10% params của teacher, khả năng cao nó không đủ capacity học hết kiến thức. Bắt đầu với 30-50% params.
-
Data augmentation: student dễ overfit hơn teacher — dùng augmentation mạnh hơn khi train student.
-
Intermediate-layer matching: với deep models, chỉ học output cuối thường không đủ — match thêm hidden layers giữa teacher và student.
-
Ensemble teachers: nếu bạn có nhiều teacher models (trained với seeds khác nhau hoặc architectures khác nhau), distill từ average của chúng → student robust hơn.
-
Đừng quên hard labels: một số paper chỉ dùng soft loss, nhưng thực tế kết hợp cả hard + soft loss cho kết quả ổn định hơn.
Tương Lai Của Model Distillation
Distillation đang phát triển theo hai hướng:
-
Self-supervised distillation: không cần labeled data — student học từ teacher qua contrastive learning, masked modeling. Ví dụ: DINO (self-distillation for vision transformers).
-
Cross-modal distillation: distill kiến thức từ multimodal teacher (text+image) sang unimodal student (chỉ text hoặc chỉ image). Ứng dụng: tạo text encoder nhỏ từ CLIP.
Với sự bùng nổ của LLMs (GPT-4, Claude, Gemini), distillation trở thành công cụ thiết yếu: các công ty distill model hàng trăm tỷ parameters xuống 7-13B để chạy on-premise hoặc trên cloud với chi phí thấp hơn.
Kết luận: Model distillation không phải thay thế hoàn toàn model lớn, mà là cầu nối giữa nghiên cứu (models khổng lồ, SOTA accuracy) và sản phẩm (models gọn, nhanh, rẻ). Nếu bạn đang build ứng dụng AI thực tế — đặc biệt realtime, edge, hoặc scale lớn — distillation là kỹ năng bắt buộc phải biết.
Đọc thêm:
- Quantization Trong AI: Giảm Kích Thước Model 10 Lần Mà Vẫn Giữ Chất Lượng — kỹ thuật nén AI bổ sung cho distillation, giảm precision xuống INT8 mà vẫn giữ accuracy.
- Local LLM: Chạy AI Mạnh Mẽ Trên Máy Tính Cá Nhân 2026 — distilled models là lựa chọn lý tưởng khi chạy LLM offline, tìm hiểu cách deploy chúng trên máy cá nhân.
- AI Edge Computing: Chạy AI Trên Thiết Bị Không Cần Cloud 2026 — distillation giúp đưa AI lên thiết bị edge; bài này chỉ cách optimize cho mobile và IoT.


