KV Cache & Attention Optimization: Bí Quyết LLM Xử Lý Nhanh Context Dài
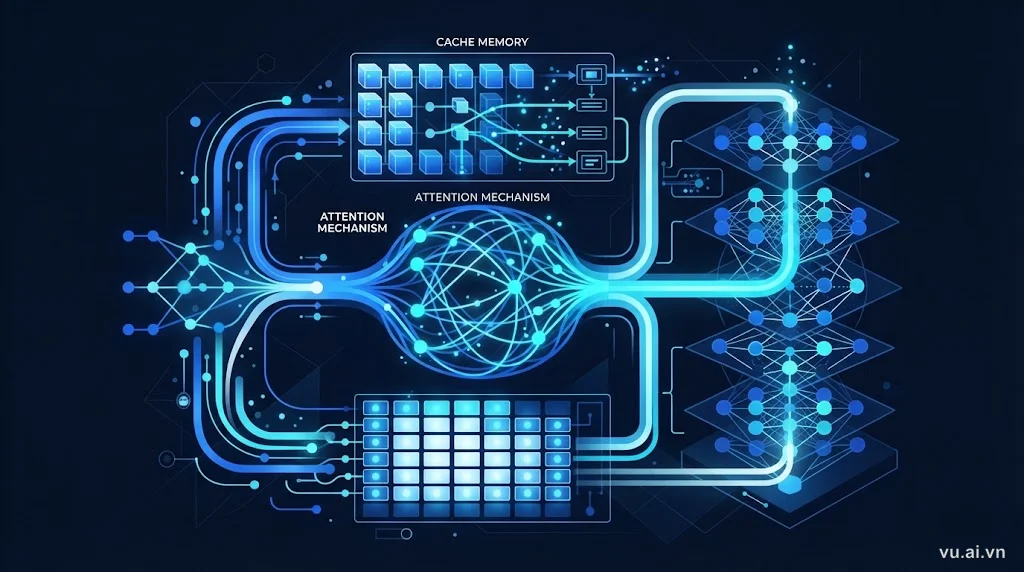
KV Cache là cơ chế lưu trữ kết quả tính toán Attention trước đó, giúp LLM tăng tốc xử lý context dài từ 3-10 lần. Kết hợp Multi-Query Attention (MQA), Grouped-Query Attention (GQA), và Flash Attention, bạn có thể chạy model với context window 100K token — độ trễ thấp, tiết kiệm tới 70% VRAM.
KV Cache Là Gì và Tại Sao Quan Trọng?
KV Cache (Key-Value Cache) là bộ nhớ đệm lưu các ma trận Key và Value đã tính toán trong các layer Attention của transformer. Khi LLM sinh text, mỗi token mới chỉ cần tính Attention với các token trước đó một lần — những kết quả này được cache lại thay vì tính lại từ đầu.
Ví dụ thực tế: Khi bạn chat với ChatGPT, mỗi câu trả lời dài 100 từ, model phải sinh 100 token lần lượt. Không có KV Cache, token thứ 100 sẽ phải tính lại Attention với 99 token trước — tốn gấp 100 lần compute. Với KV Cache, chi phí giảm xuống gần như hằng số.
Tại Sao KV Cache Lại “Ngốn” VRAM?
KV Cache chiếm bộ nhớ GPU lớn — với model 7B parameters, context 32K token có thể tốn 3-5 GB chỉ riêng cache. Công thức:
KV Cache Size = 2 × num_layers × d_model × context_length × precision
Ví dụ: Llama 2 70B (80 layers, d_model=8192, FP16):
- Context 4K: ~5 GB
- Context 32K: ~40 GB
Đây là lý do tại sao context dài vừa chậm vừa tốn tài nguyên.
Multi-Query Attention (MQA): Chia Sẻ Key-Value Giữa Các Head
Standard Attention dùng nhiều “head” song song (multi-head attention) — mỗi head có bộ Key/Value riêng. MQA giảm số head của Key/Value xuống còn 1, tất cả Query head chia sẻ chung.
Lợi ích:
- Giảm KV Cache 4-8 lần (từ 32 head xuống 1 head)
- Tăng tốc inference 30-50% nhờ bandwidth thấp hơn
- Trade-off nhỏ: quality giảm ~1-2% trên benchmark
Model áp dụng: PaLM, Falcon 40B, StarCoder.
Grouped-Query Attention (GQA): Cân Bằng Giữa MHA và MQA
GQA là trung gian: thay vì 1 head Key/Value (MQA) hoặc N head (standard), dùng G group (ví dụ 4-8 group). Mỗi group chia sẻ Key/Value cho vài Query head.
So sánh:
| Kỹ thuật | KV Heads | KV Cache Size | Quality | Tốc độ |
|---|---|---|---|---|
| Multi-Head Attention (MHA) | 32 | 100% | Baseline | Baseline |
| Grouped-Query Attention (GQA) | 4-8 | 25-12% | -0.5% | +20-30% |
| Multi-Query Attention (MQA) | 1 | 3% | -1-2% | +40-50% |
Model áp dụng: Llama 2 70B, Mistral 7B, Gemma.
GQA là lựa chọn sweet spot — giữ được 98-99% chất lượng model mà vẫn giảm đáng kể chi phí.
Flash Attention: Tính Attention Nhanh Hơn Nhưng Chính Xác Như Cũ
Flash Attention (v1, v2) là thuật toán IO-aware — tối ưu cách đọc/ghi memory trong quá trình tính Attention thay vì thay đổi công thức toán học.
Cải tiến chính:
- Tiled computation: Chia ma trận Attention thành block nhỏ, tính tuần tự trong SRAM (nhanh) thay vì HBM (chậm)
- Recomputation: Không lưu toàn bộ ma trận Attention (N²), mà tính lại on-the-fly khi cần (backward pass)
- Kernel fusion: Gộp các phép toán liên tiếp thành 1 GPU kernel
Kết quả: Tăng tốc 2-4 lần, giảm memory usage 5-20 lần, độ chính xác giống hệt standard attention (numerically equivalent).
Flash Attention 2 vs 1: Cải Tiến Gì?
Flash Attention 2 (2023) tối ưu thêm:
- Parallelize theo sequence dimension (không chỉ batch/head)
- Giảm non-matmul FLOPs
- Tăng tốc thêm 1.5-2x so với v1
Benchmark thực tế (A100 80GB, Llama 2 7B):
- Context 8K: 150 tokens/s (v1) → 280 tokens/s (v2)
- Context 32K: 45 tokens/s (v1) → 95 tokens/s (v2)
Hỗ trợ: Hầu hết framework hiện đại (Hugging Face Transformers, vLLM, TensorRT-LLM) đều tích hợp sẵn Flash Attention 2.
Sliding Window Attention: Trade Context Toàn Cục Lấy Tốc Độ
Thay vì mỗi token attend toàn bộ sequence (O(N²)), Sliding Window Attention chỉ attend W token gần nhất (W = window size, thường 4K-8K).
Ưu điểm:
- Giảm complexity từ O(N²) xuống O(N×W)
- KV Cache chỉ giữ W token cuối → fixed memory
- Context 100K token vẫn chạy như context 8K
Nhược điểm:
- Mất khả năng tham chiếu thông tin xa (>W tokens)
- Không phù hợp task cần long-range dependency (legal analysis, book summarization)
Model áp dụng: Mistral 7B (window 4K), Longformer, BigBird.
Khi Nào Dùng Sliding Window?
- Chatbot / assistant: User hỏi về đoạn chat gần đây → OK
- Code completion: Chỉ cần vài trăm dòng trước → OK
- Document QA dài: Cần đọc toàn bộ 50 trang → KHÔNG phù hợp, dùng RAG hoặc sparse attention thay thế
PagedAttention: Quản Lý KV Cache Như Hệ Điều Hành Quản Lý RAM
Inspired từ virtual memory của OS, PagedAttention (vLLM) chia KV Cache thành các block cố định (page) thay vì cấp phát liên tục.
Lợi ích:
- Giảm fragmentation: Memory không bị phân mảnh khi xoá request cũ
- Sharing: Nhiều request với cùng prefix (system prompt) chia sẻ KV Cache
- Tăng throughput 2-3x khi chạy nhiều request song song
Ví dụ thực tế: 10 user cùng hỏi ChatGPT với cùng system prompt 500 token — PagedAttention lưu KV của 500 token đó 1 lần, 10 request đều trỏ đến. Tiết kiệm 90% memory cho phần prefix.
Framework áp dụng: vLLM (production-grade), TGI (Text Generation Inference).
Sparse Attention: Chỉ Attend Vào Những Gì Quan Trọng
Sparse Attention patterns giảm số cặp token cần tính Attention bằng cách định nghĩa mask pattern — chỉ một số vị trí được phép attend.
Các pattern phổ biến:
- Local + Strided: Attend local window + mỗi K token xa (Longformer)
- Random: Thêm một số cặp random để giữ global info (BigBird)
- Learned: Model tự học pattern nào quan trọng (Reformer)
Trade-off: Giảm compute nhưng tăng code complexity, không phải lúc nào cũng nhanh hơn Flash Attention trên hardware hiện đại.
Tối Ưu Thực Tế: Kết Hợp Nhiều Kỹ Thuật
Trong production, các kỹ thuật thường được stack:
Setup chuẩn cho serving LLM 7B (2026):
# Llama 2 7B + vLLM + Flash Attention 2 + GQA
from vllm import LLM, SamplingParams

llm = LLM(
    model="meta-llama/Llama-2-7b-chat-hf",
    tensor_parallel_size=1,
    gpu_memory_utilization=0.9,
    max_model_len=32768,           # Context window
    enable_prefix_caching=True,    # PagedAttention prefix sharing
    trust_remote_code=True
)
# Flash Attention 2 tự động bật nếu có thư viện

prompts = ["..." * 100]  # Long context
outputs = llm.generate(prompts, SamplingParams(max_tokens=512))
Kết quả benchmark (A100 40GB):
- Throughput: 1,200 tokens/s (batch 8)
- Latency (first token): 180ms
- Memory: 24 GB (bao gồm model + KV cache 32K context)
So với implementation naive (PyTorch default):
- Tăng tốc: 4.5x
- Giảm memory: 55%
Monitoring và Debug KV Cache
Cách Kiểm Tra KV Cache Đang Chiếm Bao Nhiêu VRAM
import torch

# Trong PyTorch (Hugging Face)
model.generate(..., return_dict_in_generate=True, output_attentions=True)

# Với vLLM: check qua metrics
# prometheus endpoint /metrics
vllm_cache_usage_bytes
vllm_num_requests_running
Dấu Hiệu KV Cache Overflow
- OOM error khi context tăng đột ngột
- Throughput giảm mạnh khi nhiều request dài
- Latency tăng phi tuyến (không tỉ lệ với context length)
Fix:
- Giảm
max_model_lenhoặc batch size - Bật quantization (GPTQ/AWQ) — giảm KV Cache 50-75%
- Chuyển sang model GQA/MQA (Mistral, Gemma)
So Sánh Model Theo Kiến Trúc Attention
| Model | Attention Type | KV Cache Efficiency | Best For |
|---|---|---|---|
| GPT-3/4 | MHA | Baseline (100%) | Quality tối đa |
| Llama 2 7B/13B | GQA (32→8 groups) | 25% | Cân bằng speed/quality |
| Llama 2 70B | GQA (64→8 groups) | 12.5% | Large model tiết kiệm |
| Mistral 7B | GQA + Sliding Window | 15% + bounded | Inference nhanh |
| Falcon 40B | MQA | 3% | Tốc độ tối đa |
| Gemma 7B | MQA | 3% | Edge devices |
Khuyến nghị 2026: Ưu tiên model GQA (Llama 2, Mistral) — quality gần như không giảm mà tăng tốc rõ rệt.
Xu Hướng 2026: Infinigen & Unlimited Context
Các nghiên cứu mới hướng tới “context không giới hạn”:
- Attention Sinks (StreamingLLM): Giữ một số token đầu + sliding window → model ổn định với context vô hạn
- RingAttention: Phân tán context qua nhiều GPU, mỗi GPU chỉ giữ 1 phần KV Cache
- Infinigen (Microsoft): Compress KV Cache cũ thành embedding, chỉ giữ full cache cho context gần
Thực tế production (Q4 2026): Context 128K đã phổ biến (GPT-4 Turbo, Claude 3), nhưng 1M+ vẫn experimental.
FAQ
KV Cache có cần thiết cho task ngắn không?
Không — chat ngắn (<2K token), lợi ích KV Cache không đáng kể. Nhưng khi batch nhiều request, PagedAttention vẫn giúp tăng throughput.
Flash Attention có giảm chất lượng output không?
Không — Flash Attention numerically equivalent với standard attention. Tốc độ tăng nhưng kết quả y hệt.
MQA/GQA có làm model “ngu” đi không?
Ít — GQA giảm <1% trên benchmark MMLU/GSM8K. MQA giảm 1-2%. Trade-off đáng giá cho inference production.
Tại sao Llama 2 70B dùng GQA mà 7B không?
Model lớn bị giới hạn bởi memory bandwidth — GQA giảm KV Cache giúp tăng tốc rõ rệt. Model nhỏ compute-bound hơn, lợi ích GQA ít hơn (nhưng Llama 3 8B đã chuyển sang GQA).
Quantization (INT8/INT4) ảnh hưởng KV Cache thế nào?
KV Cache cũng được quantize → giảm memory 50-75%. GPTQ/AWQ quantize cả weights lẫn KV, quality giảm 2-5% nhưng vẫn acceptable cho chatbot.
Kết Luận: Lựa Chọn Kỹ Thuật Phù Hợp
Checklist tối ưu LLM inference:
- Baseline: Bật Flash Attention 2 (free speedup, no quality loss)
- Context <32K: Dùng model GQA (Llama 2, Mistral) + vLLM
- Context >32K: Thêm Sliding Window hoặc sparse attention
- Batch serving: Bật PagedAttention prefix caching
- Low memory: Quantize GPTQ/AWQ + MQA model (Gemma)
Tương lai: Theo dõi RingAttention (multi-GPU) và Infinigen (compress old cache) cho context 1M+.
Đọc thêm:
- Structured Output & JSON Mode: Lập Trình AI Đáng Tin Cậy 2026 — kết hợp KV Cache tối ưu với JSON schema để LLM trả output đúng format 100%
- Quantization Trong AI: Giảm Kích Thước Model 10 Lần Mà Vẫn Giữ Chất Lượng — quantize cả weights lẫn KV Cache xuống INT4/INT8 để tiết kiệm memory
- Local LLM: Chạy AI Mạnh Mẽ Trên Máy Tính Cá Nhân 2026 — áp dụng Flash Attention + quantization để chạy Llama 2 70B trên GPU tiêu dùng


